
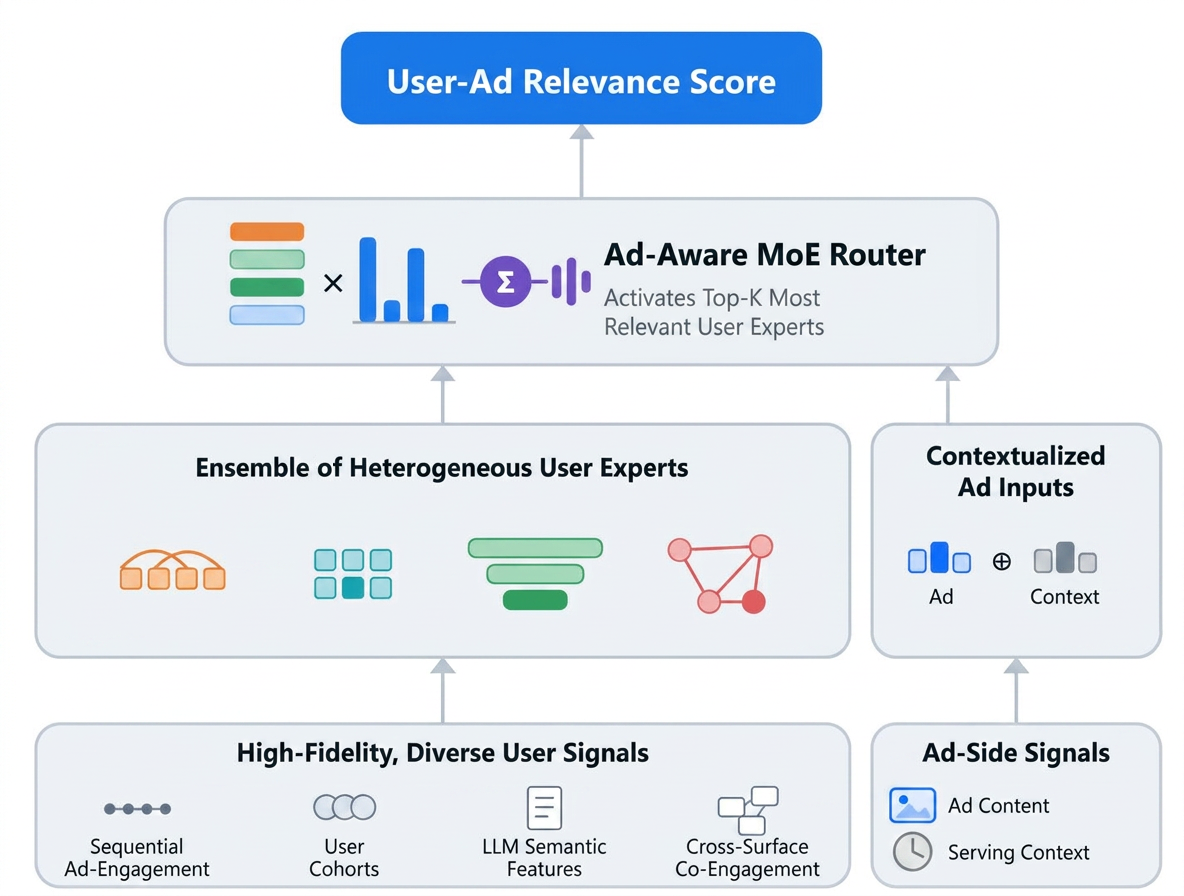
你刷到一条广告前,系统要先做一次限时海选:从海量合格广告中快速挑出少量候选,再交给更精细的模型决定展示顺序。候选选得不准,后面再聪明也无济于事;筛选做得太慢,用户又不能一直等。
Meta近日披露了新一代个性化广告检索引擎 Andromeda。它的核心思路不是单独换一个更大的模型,而是把模型、检索系统与 GPU 的执行方式放在一起设计。值得注意的是,目前关于这套新架构的效果描述全部来自 Meta Engineering 官方博客,尚无论文、第三方评测或其他独立材料交叉印证。
先把“海选”做得更聪明
广告检索(ads retrieval)是整套广告推荐流程的前半段。它先从大量符合条件的广告中筛出一小批候选;排序模型随后预测相关性、点击或转化等目标,并决定最终顺序。
两者过去有一道现实分工。排序模型判断更细,但也更耗算力,很难直接处理全部合格广告。检索模型必须更快,同时还要兼顾三个要求:别漏掉好候选,单位时间处理得足够多,并且让单次请求尽快返回。前两项分别涉及召回质量和吞吐,后一项就是延迟。
据 Meta Engineering 介绍,新一代 Andromeda 已投入生产,并能在检索阶段为每一条符合条件的广告评分。这里的范围是“每一条合格广告”,不能扩大理解为平台上的全部广告。
Meta还称,它在广告检索的规模下取得了“接近排序阶段”的模型表现。这个说法意味着,原本负责快速粗筛的环节,正在尝试采用更接近精排能力的判断方式。不过官方节选没有给出评价指标、比较基线、误差范围和实验条件,因此不能据此认定它已经达到或等同于排序模型。
模型和机器不再各做各的
这次改造的关键词是模型—系统协同设计。说白了,团队不再先把模型定好,再要求工程系统想办法扛住,而是同时调整模型结构、数据布局、批处理方式和硬件执行路径,让判断质量与线上成本一起优化。
GPU擅长一次并行处理大量计算,但广告服务还有严格的响应时间。批量太小,GPU的并行能力吃不满;为了凑大批量而等待太久,又会抬高延迟。协同设计处理的正是这种拉扯:模型怎样组织计算,系统怎样凑批和摆放数据,硬件怎样执行,不能分开考虑。
这也解释了标题为什么同时强调模型与 GPU。它关注的不是“换一张更快的卡”,而是让算法形态适合线上系统,也让系统更充分地使用硬件。不过,现有供稿没有披露具体 GPU 型号、架构改动或量化收益,无法进一步判断各项设计分别贡献了多少。
为什么现在值得看
Andromeda面对的不只是旧候选池的提速问题。Meta此前披露,早期已有超过一百万广告主在一个月内使用生成式 AI 工具制作逾一千五百万条广告。素材生产变快,检索入口承受的候选规模和变化速度也随之上升。首代系统因此已经采用模型、系统与 NVIDIA Grace Hopper 等硬件协同设计,并部署到 Facebook 和 Instagram。
故事素材显示,Andromeda从2024年下半年开始上线,负责从数千万条候选广告中选出几千条,再交给后续模型排名。到2025年,广告从业者圈里甚至出现了围绕它的投放“玄学”。广告技术评论者 Jon Loomer 曾反驳所谓“让 Andromeda 高兴”的做法,包括推翻旧广告、盲目制造大量素材版本。这段插曲反而说明:Andromeda不是一个决定所有投放结果的神秘按钮,而是广告系统里位置关键、职责明确的一层检索基础设施。
新一代架构真正值得关注之处,也正在这里。它展示了一种越来越重要的工程取向:当模型继续变复杂、候选继续增长时,提升效率不能只靠压缩模型或增加硬件。模型要怎样算,数据怎样流,GPU怎样并行,需要从一开始就共同设计。
局限与未知
- Meta所称的“接近排序阶段”缺少指标、基线和实验条件,目前只能视为官方效果表述。
- 原始摘要在“at over one”处被截断,无法确认其吞吐、延迟或规模数字。
- 官方节选未披露具体 GPU 方案及各项改动的量化收益,也没有第三方线上评测。