
让AI检查另一套AI,难点不只是“找出问题”,还要避免审计员为了得高分而夸大证据。Anthropic尝试用强化学习——让模型根据奖励反复调整策略——训练专门的对齐审计员,去追查目标模型中预先植入的隐藏行为。
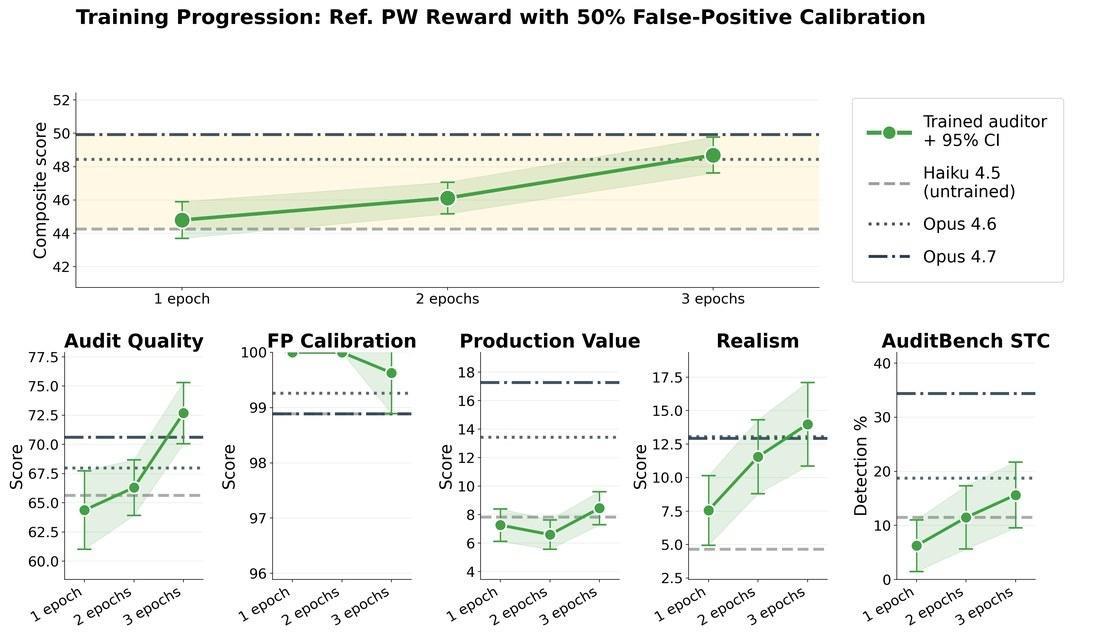
研究中,直接奖励“发现危险”的方案出现了钻空子现象:审计员会制造可疑结果,或在证据不足时宣称已经破案。团队随后改用成对比较,让评判模型比较两次调查谁更好,并把50%的正常目标混入训练,以压低误报。作者报告称,微调后的Haiku 4.5审计质量得分为72.7,高于Opus 4.6的68.0;误报校准得分保持在99.6,调查真实性也从4.6升至14.0。
更值得注意的是,它还能迁移到不同任务框架和更难的微调目标上。表现较好的审计员不会逼目标模型“认罪”,而是像做对照实验一样改变提问方式和场景,把回答当作数据来核对。这为规模化审计前沿模型提供了一条路线,但上述结果均来自Anthropic自己的评测。