
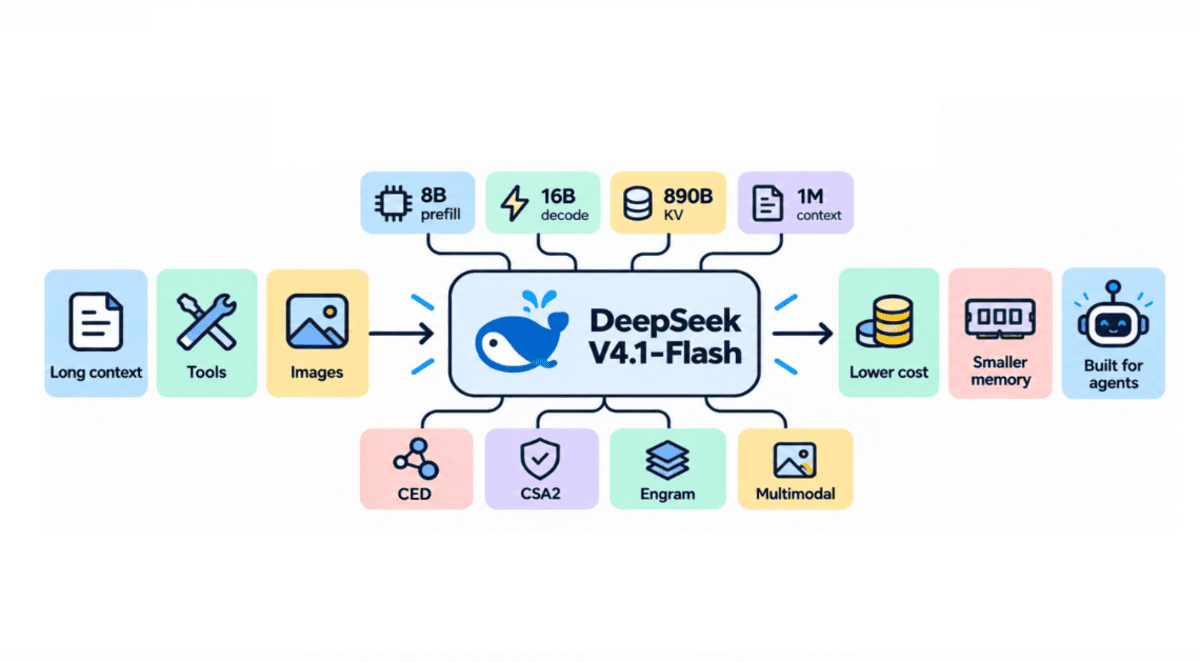
让 AI Agent 读几十万字资料再写几千字答案,贵的不只是“思考”,还有读入材料和保存上下文。DeepSeek-V4.1-Flash把这两笔成本直接纳入架构设计:推理先经过 prefill(并行读完整段输入),再进入 decode(逐词生成答案)。据 kdnuggets 作者 Abid Ali Awan 介绍,这个 552B 参数的 Mixture of Experts(MoE,多组“专家”中每次只调用少数几组)模型,在每个词的 prefill 阶段只激活 8B 参数,decode 阶段则激活 16B。
关键变化是一个 20 层因果编码器加 20 层解码器的设计。解码器可复用编码器生成的全局中间结果,不必在读入阶段层层重复计算。模型还把全局 KV cache——保存已读上下文、避免生成时从头重算的“草稿纸”——压到每词 890 字节。作者认为,这种“读时少算、生成时多算、上下文少占显存”的组合,更贴合需要反复读材料并累积状态的 Agent。上述效率数据来自该报道所述发布信息,材料未提供独立复现实验。