
你经营一款健身 App,准备给可能退订的用户打电话。最直觉的办法,是先预测谁最可能流失,再优先联系他们。但高风险用户也许早已下定决心,电话根本改变不了什么。真正该问的不是“谁会走”,而是“这通电话能让谁留下”。前者是预测风险,后者是估计因果效应——采取干预,相比不采取,结果会改变多少。
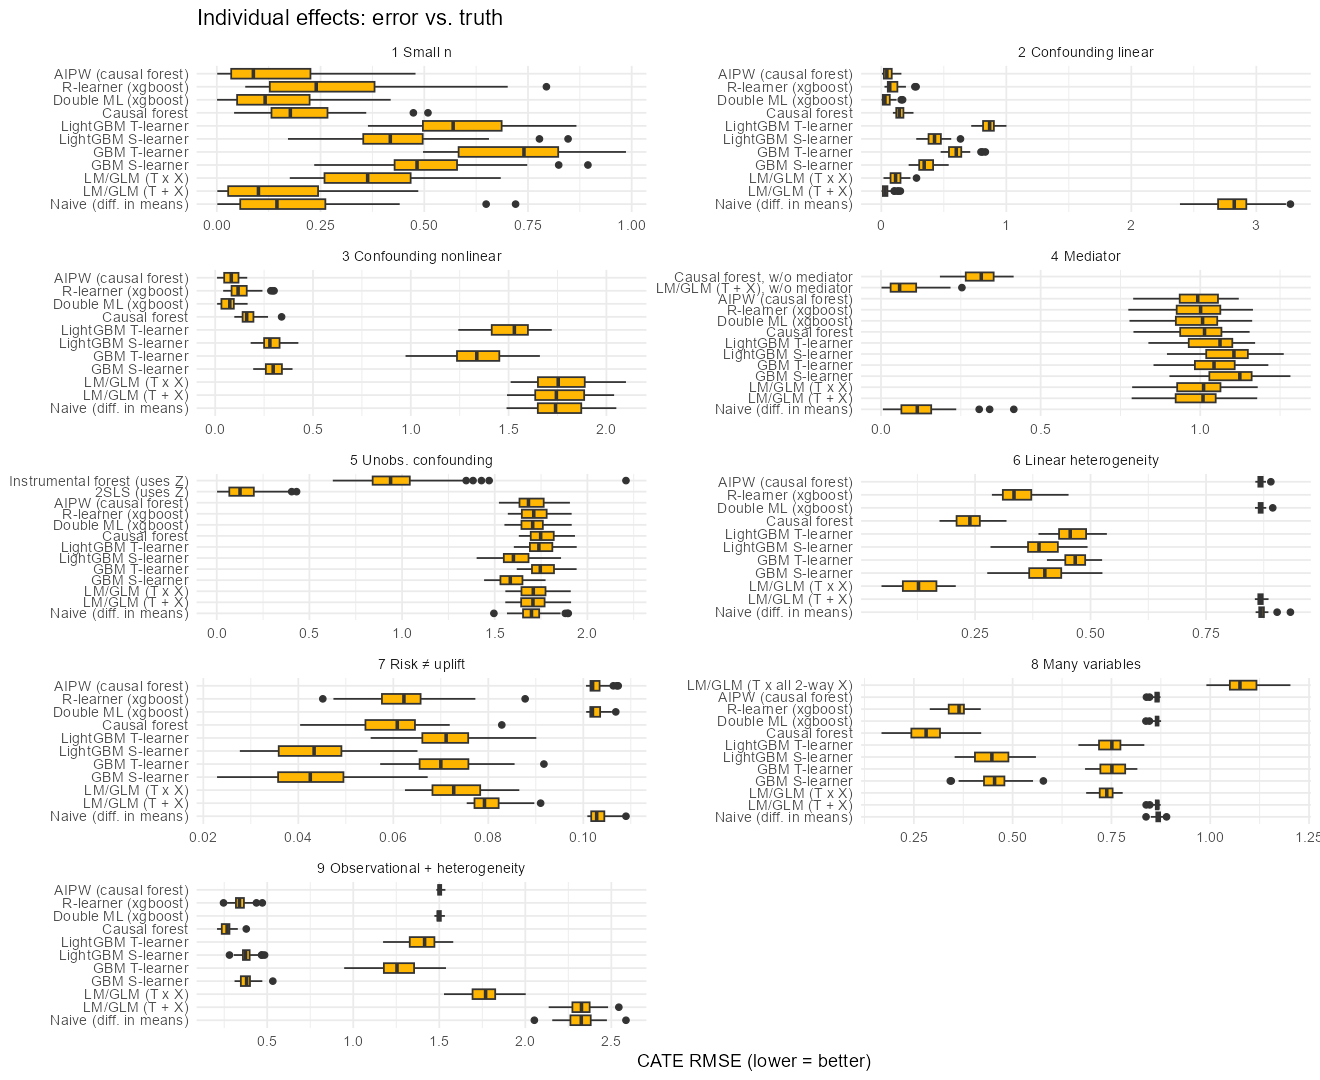
Philipp Probst 在 r-bloggers 的报告中,用9组已知真实效应的模拟实验比较了传统模型与因果机器学习,每组重复40次。它给出的答案并不是“模型越复杂越好”,而是:先确认数据能不能回答因果问题,再谈选什么算法。下文的效果结论均来自这一份报告,尚无独立材料交叉验证。
先别选模型,先问数据从哪来
如果电话、折扣或营销活动通过 A/B 测试随机分配,接受与不接受干预的人原则上可以直接比较。若干预由业务人员按经验决定,数据就属于观察数据:两组人可能在干预前已经不同。
这时最关键的是混杂因素——同时影响“谁接受干预”和最终结果的变量。例如,年龄既可能影响客服是否打电话,也可能影响用户是否退订。漏掉它,模型可能把年龄造成的差异误算成电话的效果。
报告强调,在它设置的模拟情境里,纳入错误变量或遗漏重要混杂因素时,LM、GLM、GBM和因果ML都可能给出错误结果。LM(线性模型)用较简单的数学关系描述结果;GLM(广义线性模型)还能处理“是否购买”之类的二元结果;GBM(梯度提升模型)把许多较弱的决策树逐步组合起来,能表达更弯曲、复杂的关系。但灵活不等于能凭空补回缺失的信息。算法选择排在识别条件之后:处理如何分配、关键混杂因素是否测量,才是前面的关卡。
平均效果复杂时,因果ML才显出优势
如果团队只想知道“这项活动平均是否有效”,目标是平均处理效应,即 ATE——把所有对象合在一起看,干预平均带来多大变化。
报告的模拟显示,当影响因素以简单形式起作用,而且传统模型设定正确时,LM或GLM已经够用。只有在影响因素以非线性方式起作用的相应模拟中,因果ML才胜过传统模型:Case 3里,LM出现明显偏差,Double ML则接近预设的真实效应。
Double ML的关键思路是“先调整,再估计”:先用灵活模型处理其他影响因素,再估计干预本身的效果。按报告的解释,优势来自这一构造原则,不是某个特定算法天然更强。换句话说,如果现实关系并不复杂,因果ML未必能抵消额外的建模成本。
找高风险用户,可能找错了人
平均有效还不够。很多业务真正关心的是“有限预算应该花在谁身上”。这就涉及异质处理效应——同一通电话或同一张优惠券,对不同人的作用可能不同。
风险模型回答“谁最可能退订”,效果模型回答“电话能让谁改变决定”。两份名单可能差得很远。报告的Case 7中,优先联系流失风险最高的客户,效果甚至低于随机选择。原因是这些客户虽然危险,却可能已经很难挽回。这也解释了因果ML的实际价值:它试图寻找可被干预改变的人,而不只是预测坏结果会发生在谁身上。
不过,团队还要分清“排顺序”和“算准数值”。如果只需挑出最值得联系的30%,模型只要大致排对顺序即可。若要逐人比较电话成本与预期收益,就需要估计个体层面的条件平均处理效应,即 CATE。报告的Case 9显示,简单GLM可以选对干预对象,却会误估效果大小。排序正确,显然比每个人的增量都算准更容易。
当个体效果的函数形式未知时,causal forest(因果森林,一类用多棵树估计不同人群干预效果的方法)更值得考虑。但在Case 6那个关系简单、模型设定正确的模拟中,GLM反而表现更好。因果森林的价值因此不是“全面替代”,而是在异质性复杂且未知时提供更灵活的表达。
真正的判断顺序
这份报告给团队的实用提醒可以压成三步:先明确要预测风险、估计平均效果,还是决定干预谁;再确认处理是否随机、关键混杂因素是否进入数据;最后才在LM、GLM、GBM、Double ML或causal forest之间选择。复杂模型解决的是复杂关系,不是缺失的因果依据。
局限与未知
- 证据仅来自9组人为设定的模拟,每组重复40次,不能直接外推到所有真实业务。
- 供稿未披露样本量、数据生成过程、误差指标、置信区间和算法配置,因此“明显偏差”“更好”等说法无法独立量化核验。
- 报告提到工具变量可用于部分缺失混杂因素的情形,但现有材料没有完整说明其成立条件,不能把它视为通用补救办法。