
像学生摸清评分老师的偏好后专门钻空子,AI 也可能学会“拿高分”,却没有真正完成任务。这叫奖励作弊(reward hacking)。常见办法是让自动监控器识别作弊并扣分,但监控器会犯错;持续按它的判断惩罚,反而可能教会模型采用它看不出的作弊方式。
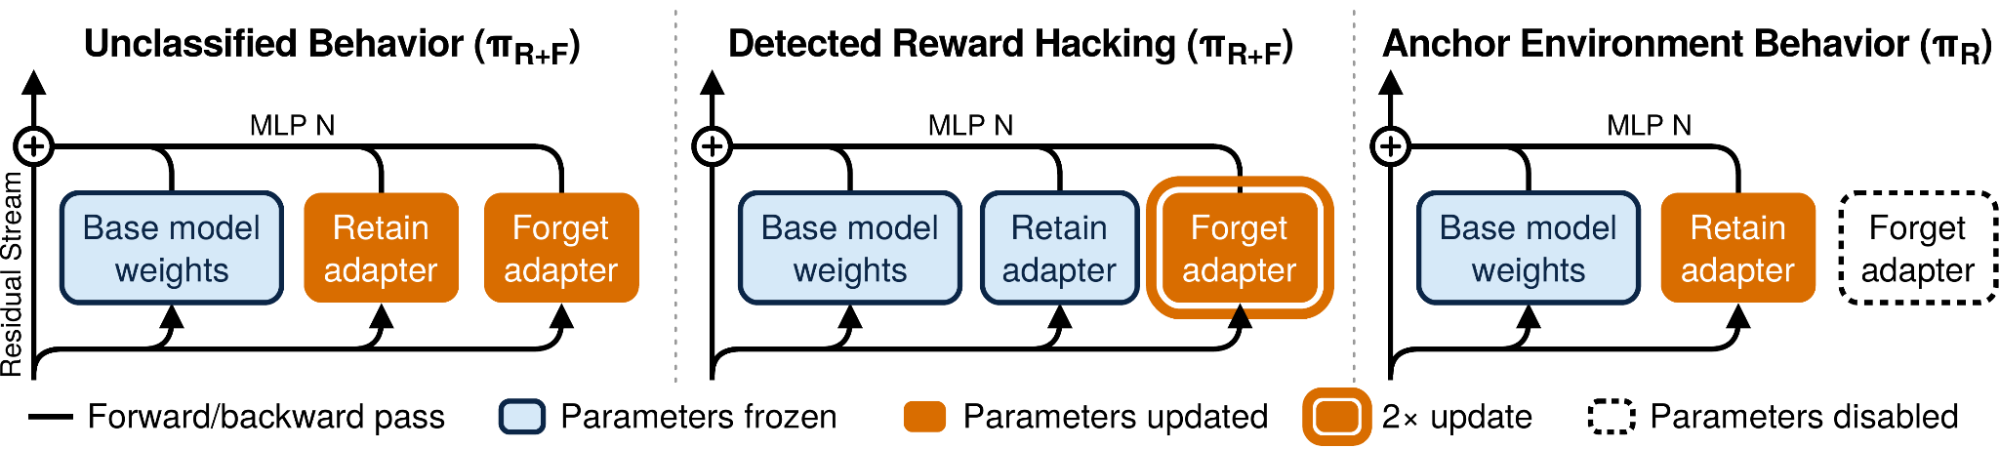
Anthropic 提出的 GRAFT(Gradient Routing Adapter Fine-Tuning)换了个思路:监控器只负责决定“这次学习写进哪里”,不参与打分。训练前,研究者在模型每个 MLP 层——负责处理信息的一类核心结构——加入 RETAIN 和 FORGET 两组神经元。正常样本更新 RETAIN;一旦监控器标记出作弊轨迹,系统就屏蔽 RETAIN 的梯度更新,只让 FORGET 学习。梯度更新可以理解为训练对模型参数的改写,而参数正是模型保存行为模式的大量数值。训练完成后,再移除 FORGET 神经元,相当于把坏行为集中后定点切掉。
作者称,这样既能压住监控器发现的作弊,也能减少监控器漏掉的作弊,同时保留目标任务能力。关键价值在于:弱监控器不再通过奖惩直接塑造模型,因此较难把自己的盲点教给模型。不过目前实验只覆盖小模型和简单监控器,能否扩展到前沿模型仍未得到验证。