
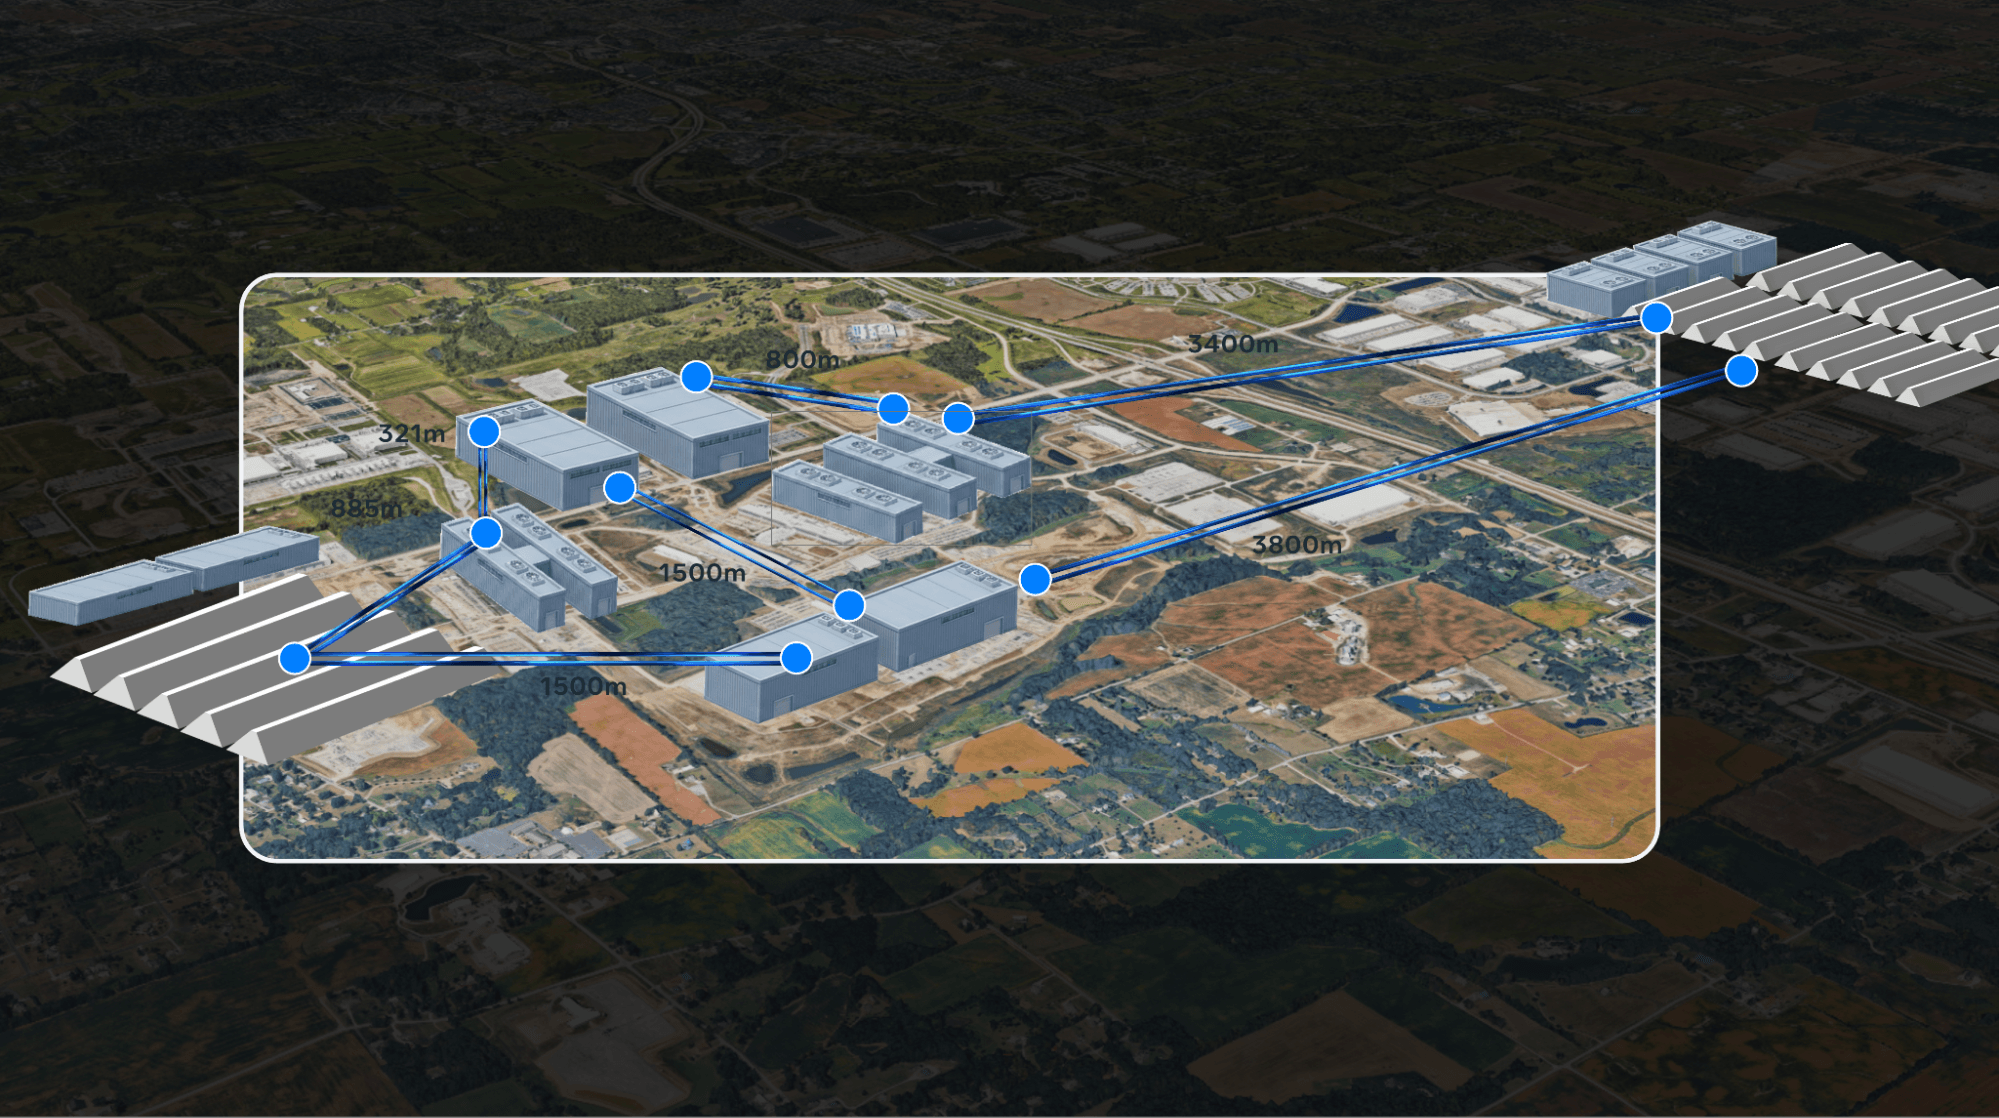
你可以把大模型训练想成一场数十万人参加的接力赛:只要一名关键选手停下来,整条队伍都可能减速。如今,Meta 正把这场比赛扩大到数十万块 GPU,并计划最终扩至约 100 万块。Prometheus 的看点因此不只是“显卡更多”,而是怎样让供电、散热、网络和建筑一起跟上。
需要先说清信源边界:本文数据全部来自 Meta 官方工程博客,尚无论文、第三方报道或可审计运行数据交叉验证。Meta 称其为“gigawatt-scale supercluster”,即吉瓦级超算集群;吉瓦是十亿瓦,描述数据中心面对的供电量级,不代表 Prometheus 目前已经以 1 GW 功率运行。
先把几座楼变成一台机器
两年前,俄亥俄州 New Albany 还是一座处理普通网络流量的常规数据中心。Meta 随后改造硬件、网络和建筑,并分阶段建设 Prometheus。第一阶段已经完工,也已用于训练 Muse 基础模型,包括 Muse Wonder。
今天的 Prometheus 由分布在多座互联建筑中的数十万块 GPU 组成。场地既有传统数据中心,也有为 AI 优化的新建筑和快速部署结构。它们通过数英里光纤连接,目标是像一台机器那样协同工作。满规模规划约为 100 万块分布式 GPU,但这仍是未来目标,不是当前数量。
“超算集群”就是用高速网络把大量服务器和加速器连起来,共同训练单台服务器装不下的模型。难点在于,训练期间 GPU 要不断交换参数和中间结果。网络稍慢,昂贵的芯片就只能等数据。规模越大,这种等待和故障造成的浪费越明显。
72块GPU,先组成一个大加速器
Prometheus 当前部署两种 NVIDIA GPU 平台,Meta 还计划加入基于 Vera Rubin NVL72 的第三种平台,但没有公布明确日期。NVL72 的思路,是让同一网络结构内的 72 块 GPU 像一个加速器那样运行。
第一种平台 Catalina 使用 GB200 NVL72。其 Ariel 版本由两个机架组成,每架放置 36 块 GPU,合计拥有 13.4 TB HBM3e——一种为加速器提供高吞吐量的内存。整套双机架系统功率约为 120 kW。
第二种平台 Clemente 使用 GB300 NVL72。它把 72 块 GPU 压进单个机架,内存提升到 20.7 TB,机架功率约为 135 kW。Meta 自报其性能比 GB200 NVL72 高 5%至10%。这些数字说明,新一代平台不只提高计算能力,也在改变机架密度、布线和冷却方式。
Prometheus 因此采用闭环液冷:冷却液在封闭回路里循环,把芯片热量带走,再继续使用。高密度机架产生的热量很难只靠空气排出,散热已经和芯片、网络一样,成为扩容的前提。
真正稀缺的是平静运行的时间
Meta 用 goodput 衡量训练资源真正用于有效工作的比例。它与“拥有多少 GPU”不同:机器虽然开着,但如果在等待通信、恢复故障或重复计算,就没有产生有效进展。
据 Meta 自报,Muse Wonder 的预训练 goodput 超过 85%,强化学习(RL,即通过反馈调整模型行为的训练方式)超过 90%。训练期间,整体墙钟时间平均中断间隔约为 4.7 万 GPU 小时;固件修复等改动随后把它提高到 5.4 万 GPU 小时以上。
这里的 GPU 小时是设备数量与运行时间的乘积,不能读成“连续运行了 5.4 万个自然小时”。但这个指标仍点出了百万 GPU 规划背后的工程现实:节点越多,某一处出故障的机会就越多,而单台主机的问题便可能拖慢甚至中止整个训练任务。
为什么值得关注
Prometheus 展示了 AI 基础设施的重心变化。过去讨论扩容,很容易只数芯片;到了吉瓦级,电网接入、机架功率、液冷、跨楼网络、故障恢复和分阶段施工必须作为一个系统设计。
它也不是在一张白纸上建成。Meta 一边保留和改造传统机房,一边加入 AI 专用建筑与快速部署结构,再用网络把异构场地缝合起来。这样的路线能更快形成训练能力,代价则是部署、维护与标准化更复杂。Prometheus 的工程价值,正在于把这些现实约束摆到了与算力数字同等重要的位置。
局限与未知
- Meta 没有披露当前实际功率、已投入运行容量,以及何时达到所谓吉瓦级规模。
- 百万 GPU 是满规模规划;当前规模只有“数十万块”这一宽泛表述,第三个平台也没有明确上线日期。
- goodput、平均中断间隔和平台性能均为 Meta 自报,缺少完整测量口径、统计周期、训练规模与外部基线,暂时无法横向比较。