
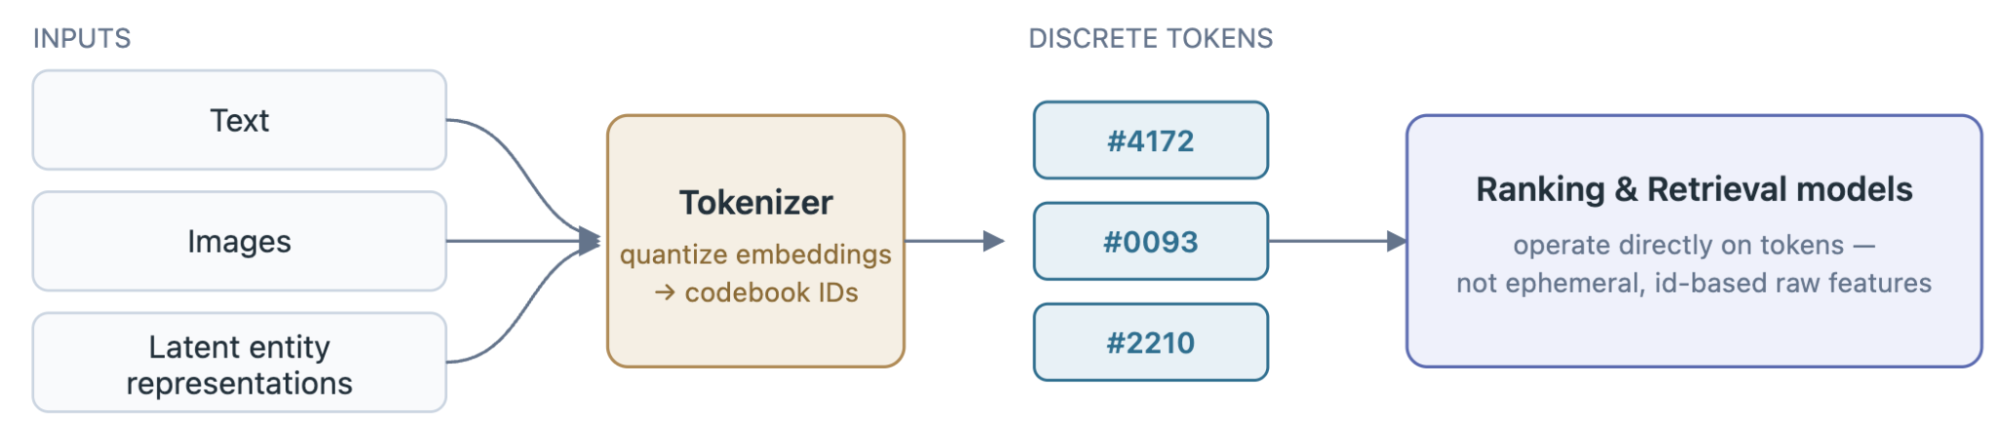
你可以把广告推荐想成餐厅点单。过去,系统拿着整本菜单,逐道估计你会不会喜欢;现在,Meta想让模型直接“说出”合适的菜名。问题是,如果菜单每次更新都把编号打乱,昨天的“42号”是跑鞋,今天却成了咖啡机,旧模型、缓存和日志就可能集体认错。
Meta于2026年10月19日发布工程文章《GenRecs Tokenization》,把稳定词表放到生成式广告推荐的基础位置。本文涉及的工作与效果论断均来自Meta官方工程博客,尚无论文、第三方测评或其他独立信源交叉验证。
推荐系统开始“说广告”
传统推荐通常逐一给候选广告打分,再选出排名靠前的内容。Meta所称的Generative Recommenders(GenRecs,生成式推荐)换了一个角度:模型联合考虑广告内容和用户偏好,像生成词语一样,直接产出代表候选广告的符号。
这里的符号叫token——模型处理和生成信息的基本单位。它不一定是自然语言里的单词,也可以代表某件商品或某类内容。所有合法token组成的清单,就是词表。换句话说,词表规定了模型“能说出哪些广告”。
Meta称,GenRecs还会利用大语言模型(LLM)已有的世界知识,让匹配更智能、更精准,并给广告主带来累积收益。不过,这些是官方的定性描述。摘要没有提供业务效果数字,也不足以证明系统已经实现了“对广告主最有利的结果”。
难点不是生成,而是别改暗号
生成式推荐要先把广告变成离散符号。模型升级时,如果同一个token的含义随之改变,问题就不只是新版模型需要重新学习。线上仍在运行的旧模型、历史日志、缓存和回退版本,都可能继续按旧含义解释它。
稳定词表要解决的正是这种错位:同一符号跨训练版本尽量保持同一含义。它像一套长期有效的商品编码。商品可以新增,模型可以更新,但已有编号不能随意换人。这样,新旧模型及其周边系统才更容易同时工作,更新也不必要求整条链路在同一刻完成切换。
Meta因此把GenRecs Tokenization——即把广告转换成token的过程——称为生成式推荐的基础数据表示。文章标题强调“Stable Model Vocabulary”,说明稳定性是其设计目标或特征;现有摘要还不能证明这一目标已经通过完整实验得到验证。
一个词表为什么会影响新商品
Meta此前用一双新款越野跑鞋解释过类似问题:旧系统给每件商品一个孤立ID,新鞋上线时几乎没有点击记录,只能从头积累。语义词表则可以让新鞋与上一季的相似鞋款共享部分token,在第一条广告还没有互动时,先继承对相似商品的认识。
据Engineering at Meta披露,团队曾测试八版tokenizer(把内容转换成token的组件),发现商品聚类越纯、token分布越均衡,后续的广告点击率预测也越准确。该表示法与GEM、Adaptive Ranking Model联用后,在Meta于2026年2月进行的内部测量中带来0.35%的转化提升。这个数字来自Meta自己的测量,材料没有给出实验设置、基线或统计显著性,不能据此判断它能否推广到其他系统。
稳定词表还可能缓解“长尾广告”的困境。曝光少的广告数据少,因此更难被准确判断,也更难获得下一次曝光。共享语义token后,它可以借用相似商品的经验获得较可靠的初始排序;新增曝光又产生训练数据,继续改善后续判断。Meta把这种反馈称为“tokenization flywheel”,也就是由词表带动的数据飞轮。
为什么值得关注
这项工作的看点,不是又多了一种模型,而是模型升级开始受制于一项不显眼的数据基础设施。把推荐改写成生成任务之后,词表不再只是训练前的准备材料。它同时成了模型、历史数据与线上服务之间的接口。
这也解释了为什么“稳定”比一次跑分更重要:模型可以频繁换代,但如果每次换代都重写符号含义,旧数据难以延续,回退版本也可能失去兼容。稳定映射让效果有机会跨版本积累,而不是每次重新起跑。
局限与未知
- 现有摘要没有披露稳定词表的具体机制、词表规模及稳定性指标。
- 材料没有提供本次GenRecs Tokenization的实验设置、对比基线、效果数字或统计显著性。
- “更智能、更精准”“累积收益”等表述均来自Meta,仍需完整技术文章或独立评测验证。