
打开 Netflix,首页并不是一个模型包办的:多个专用模型分别决定内容如何打分、排序和组合。问题是,每个模型都要单独维护,也容易重复学习同一件事——你喜欢什么。Netflix 因此训练了一套个性化基础模型:从大规模用户互动历史和内容数据中统一学习偏好,再把学到的结果交给不同应用。
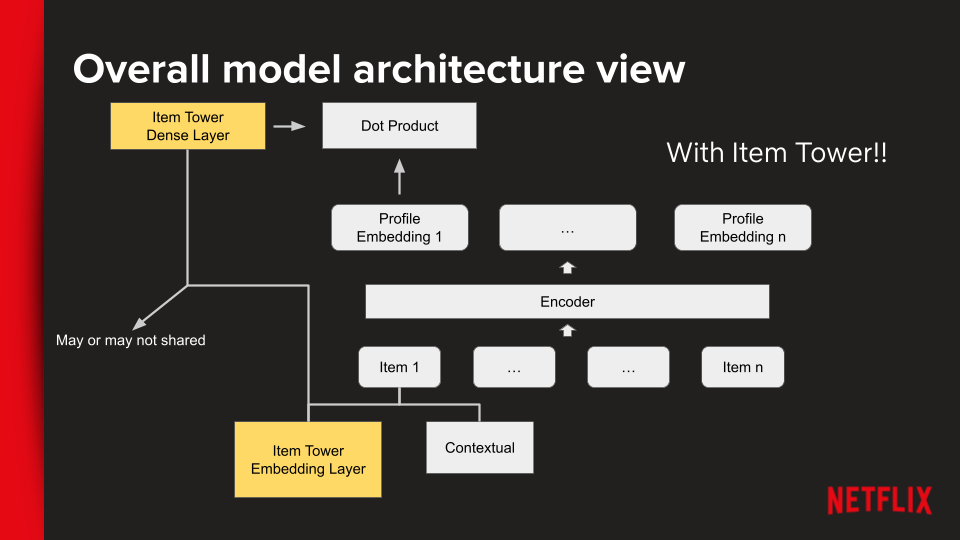
真正值得看的是接入方式。Netflix 没有让大模型直接替换成熟的推荐系统,而是按延迟要求、技术栈限制和团队需求,采用三条路径:输出 embeddings(把用户和内容压缩成可计算的向量)供现有模型使用;抽取模型的部分计算子图接入应用;或通过 fine-tuning(在特定任务数据上继续训练)深度适配。三种方案均已用于不同生产场景。Netflix 未在这篇材料中披露统一的效果数字,但这次分享补上了一个更现实的环节:大模型如何进入已经运行多年的推荐系统,而不是只停留在训练与推理演示中。